Active Recordのinsert_allをto_sqlする方法
背景
あるテーブルの200万件くらいのレコードを、別のテーブルに移行する必要があった。 移行バッチを実装するにあたって、find_in_batchesのバッチサイズやバルクインサートの単位を、中間オブジェクトや生成されるINSERT文のデータサイズから決めたかった。
find_in_batchesにおけるバッチサイズは移行バッチを実行するサーバーに割り当てるメモリ量を左右するし、PostgreSQLは実行可能なクエリサイズの上限を決めるオプション(MySQLで言うところのmax_allowed_packet)はなく、プロセスに割り当てられているメモリがそれにあたるため。
今回は特にPostgreSQLで実行可能なクエリサイズを上限の範囲内に収まるかどうかを検証する課程で、ActiveRecordのinsert_allメソッドからINSERT文をdumpする方法を模索したので、備忘として書いておきたい。
やったこと
find_in_batchesの各バッチの中で、insert_allメソッドを使っていたので、作成されるINSERT文を文字列として取得することにした。 参照系のクエリだとクエリの実行前にto_sqlできるが、insert_allなどの書き込み系のクエリだと呼び出し時に実行されてしまう。 それらしき公開APIなども存在しなかったので、INSERT文をdumpする方法を探してみた。
Active Recordのソースコードを見てみると、insert_allメソッドの中でInsertAllクラスのインスタンスが呼び出されており、このInsertAllクラスのprivateメソッドにto_sqlが実装されていることがわかった。
insert_allで渡す引数をそのまま、ActiveRecord::InsertAll.newとしてto_sqlメソッドを呼び出したところ、ほしかったINSERT文を出力することができた。
to_sqlする方法
以下、例
# 内部APIを使って、insert_allメソッドをto_sqlする
query = ActiveRecord::InsertAll.new(対象のモデル, 保存対象の配列, on_duplicate: 重複時の挙動).send(:to_sql)

puts query
得たクエリ文字列を使って、byteサイズを出したい場合は以下のようにする
# 内部APIを使って、insert_allメソッドをto_sqlする
query = ActiveRecord::InsertAll.new(対象のモデル, 保存対象の配列, on_duplicate: 重複時の挙動).send(:to_sql)

# 文字列のバイト数を取る
puts query.bytesize
GCPのリソースと認証・認可の方法
GCP上のリソースにアクセスする場合、公式から提供されているCLIやプログラムからアクセスするためのSDKなど、使用するクライアントに応じて複数の認証・認可の方法が用意されている。 どのような場合にどの認証・認可方法を採用すべきか迷うことが多いので、整理しておきたい。
まず、認証と認可について簡単に整理しておく。Auth0のドキュメントより
- 認証: ユーザーが本人かどうかを確認するプロセスのこと
- 認可: リソースがどの対象にアクセスすることができるか?どのアクションを実行することができるか?を確認するプロセスのこと
認証・認可の種類
操作によって認証・認可の方法が異なる
【CLI】GCPで提供されている各CLIを使用する場合
1. ユーザーアカウントによる認可
認可の方法
- gcloud init
- 認可 + configurationsも同時に作成してくれるコマンド
- 対象のユーザーアカウントにはじめて認可する場合に使用する
- gcloud auth login
- 認可のみを行うコマンド
2. サービスアカウントによる認可
- 特定のGoogleユーザーとは関係のないサービスアカウントを使用した認可方法
- Cloud SDK を本番環境へのマシンのデプロイの一環としてインストールして設定する場合や、すべてのユーザーが
rootにアクセスできる Compute Engine 仮想マシン インスタンスで使用する場合に推奨される。- CIやCDなど
- 運用効率化のためのシステムから各コマンド実行したい場合は、特定のユーザーに紐づいていない形で実行したいはずなのでこっち?
認可の方法
- gcloud auth login (--cred-fileオプションを設定)
詳しくは以下
【プログラム】GCPのAPIやSDKなどのプログラムを実行する場合
- Application Default Credentials (ADC)を使うことが推奨される
- ADCに則ることで、Google Client LibraryやGoogle API Client LibraryなどのSDKを使用したアプリケーションプログラムから認可済の認証情報を自動で検索して使用することがきる
- ADCを使用すると、同じ認証・認可方法で開発環境や本番環境でコードを実行することができるので管理もしやすい
ADCによる認可済認証情報の検索
GOOGLE_APPLICATION_CREDENTIALS環境変数
- Workload Identity 連携の認証情報構成ファイル
- Workload Identity 連携の認証情報構成ファイル
- こちらで分かりやすく解説されている
- サービス アカウント キー
- 漏洩するリスクが高いため、非推奨
- Workload Identity 連携の認証情報構成ファイル
gcloud cliで設定されたユーザー認証情報
接続済のサービスアカウント
上から順番に検索に該当したものが選択・使用される
詳しくは以下
使い分けの判断方法
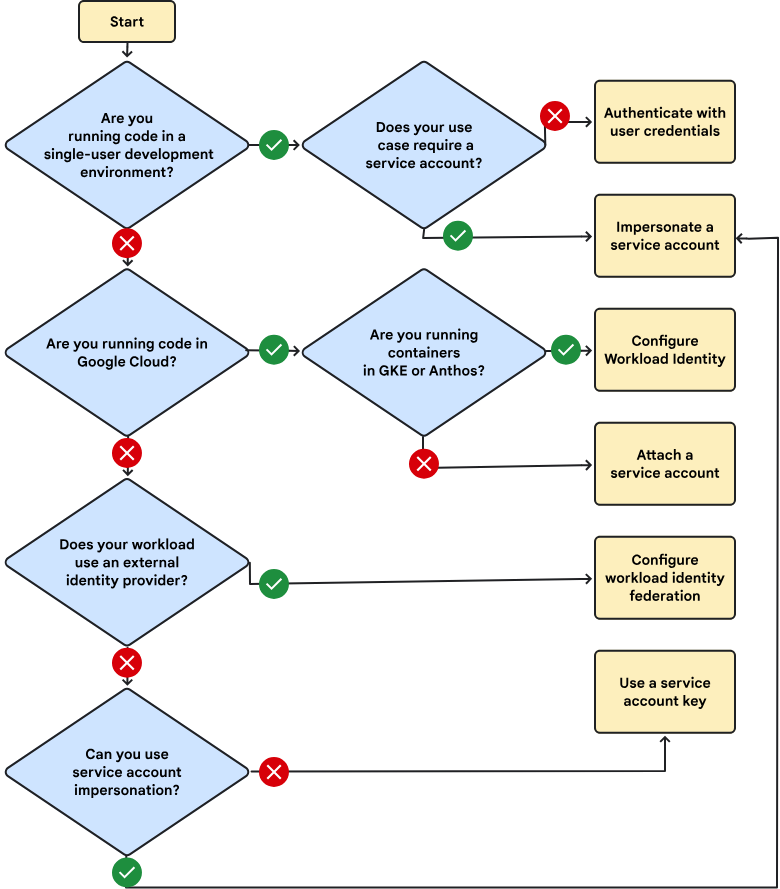
リモート環境での認証・認可方法の使い分けに関しては、公式ドキュメントに判断のためのフローチャートが用意されていた。
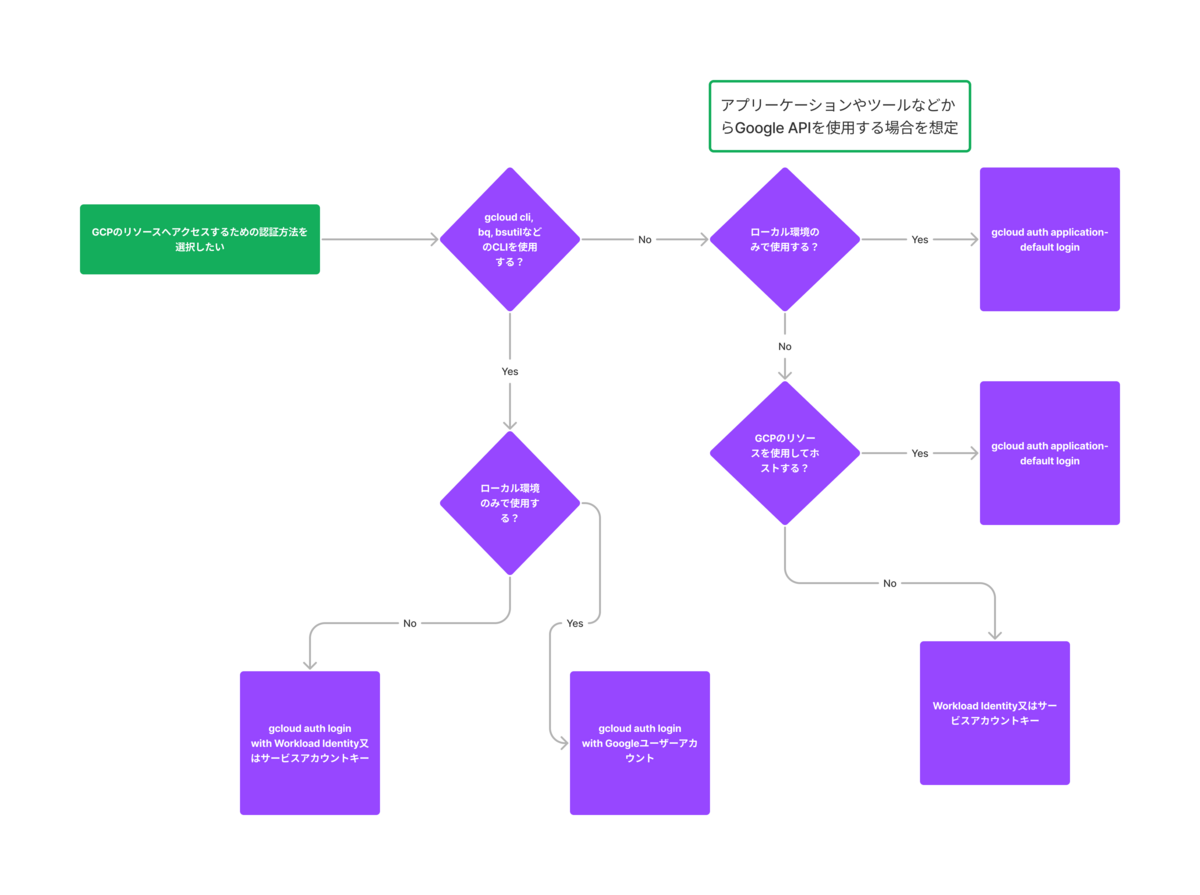
ローカル環境でクライアント毎にどの認証・認可の方法を採用するとよさそうか、同じようにフローチャートで整理しておく。
ローカル環境編
リモート環境編
データベース間のテーブル差分を比較するスクリプトを作成した
同じスキーマを持つ異なるデータベース間でテーブルの差分を確認したいことがあって、テーブル毎に差分を確認するのも面倒なのでデータベースの全テーブルを比較して差分を出力するスクリプトを作った。 今後もデータのマイグレーションなどで使えそうなので、備忘として残しておく。
作ったもの
#!/bin/bash

BASE_DB_URL="postgresql://user:password@host:5432/db_name" # 比較元のDBのURL
TARGET_DB_URL="postgresql://user:password@host:5432/db_name" # 比較対象のDBのURL
TABLES=`psql "$BASE_DB_URL" -t -A -F"," -c "SELECT table_name FROM information_schema.tables WHERE table_schema = 'public';"`

while IFS="," read -r TABLE_NAME
do
  echo "=== $TABLE_NAME ==="

  data-diff \
  "$BASE_DB_URL" \
  "$TABLE_NAME" \
  "$TARGET_DB_URL" \
  "$TABLE_NAME" \
  -k id \
  --json || { echo "idカラムが存在しないテーブルです"; continue; }
  # -d \ # デバッグ情報の表示
  # -v \ # 詳細情報の表示
  # -c activity \ # その他の比較対象にするカラム
  # -w "event_timestamp < '2022-10-10'" # where句を指定
done <<EOD
$TABLES
EOD
data-diffというテーブル同士の差分を比較するツールに、データベース間のテーブル同士の差分を確認する機能もあったので、それを活用した。 今回はPostgreSQLのデータベースで使用することが前提。
- 比較元のデータベースから比較対象のテーブル一覧を取得する
- テーブルごとに比較元のデータベースと比較対象のデータベースをdata-diffコマンドで比較(idカラムが存在しないテーブルは比較対象外に)
- 結果をjson形式で出力する
というシンプルなものを作成した。
取りたい情報や絞り込みたい条件がある場合は、コメントアウトしている各オプションを指定してやる。
参考
2023年の振り返り
年も瀬なので、開発関連の取り組みを雑に書きなぐっておこうと思う。 また来年の年の瀬に見てやるべきことがしっかりやれたかを確認できればと。
今年やれたこと・やってみたこと
SREっぽい動き
特に組織上SREというポジションに就いているわけではないが、ソフトウェアエンジニアとして、担当しているサービスや一部その関連サービスの
- HerokuからGCPへのプラットフォーム移行
- 監視やオブザーバビリティ担保に向けた取り組み
- 障害時のガイドライン策定
- SLOに対してのボトルネック特定やSQLチューニング
- 自動テストの作成についてのガイドライン策定
などに関わることができた。 特にインフラ領域に関しては、業務委託としてお手伝いいただいている専門家の方とプロジェクトを一緒に進める中で、試行錯誤して作った既存のアウトプットが正しくよいものへブラッシュアップされていくことが嬉しかったし、そこからいろいろ学ばせてもらうことができている。
SLOに対してのボトルネック特定に関しては、HerokuのDynoが突然ダウンする問題が半年ほど問題になっていたが、PumaやPostgreSQLサーバーのメトリクスを可視化するところからAPMによる計測までを行いながら問題を切り分けていった。 結果的にSQLクエリ自体や投げ方のまずい箇所が特定と改善ができたし、HerokuのH12エラー起因の障害について何が原因になりうるかについて分かったことも多かった。
「推測するな、計測せよ」を実感した。
技術負債のコントロール
サービスのスケールに伴って、チームで技術負債とうまく付き合っていくために、以下のような取り組みをはじめてみた
- 時間がかかる技術課題や顕在化した負債を計画的に解消していくために、プロダクトチームのOKRとして目標化を行う
- 週次の開発振り返り会(DevOps MTG)の実施
技術課題を起票する目的や解消のための時間確保について、よりチームで意識できるようになってよかったと感じている。
技術広報
つい2,3ヶ月の間の話ではあるが、会社のテックブログの編集長になった。 一旦これまでの整理として、振り返りを行った上でこれまでのブログ運用の方針を引き直してみたりした。 また、今年は他社と共同で勉強会やLTを主催する試みを年の後半からはじめて、年内に2回開催することができた、継続してよいイベントにしていきたい。
個人開発
共有家計簿のアプリ、彼女が経理の仕事をしているということもあり、お金の管理観点で自分達の使いやすいものを作っている。 たまたま社内に同じような家計簿の管理をしたいメンバーがいたので使ってもらっていて、自分たち以外からもフィードバックが返ってくるので結構楽しく開発を続けられている。
やりきれなかったこと
開発チームのアウトカムを分かりやすく説明すること
プロダクト開発とは直接的に関わりのない部署や役割のメンバーに対して、開発チームのアウトプットやアウトカムにわかりやすく説明することがなかなか難しく感じることが多かった。
まずは、意識的に開発起点の情報にふれる接点を増やしていくこと。 徐々に各役割で追っているKPIをブレークダウンして、開発のアウトカムとしていくことが大事だと今のところ考えている。
個人としての発信
ブログ執筆を推進していく立場なので、テックブログや個人でも投稿の数・質ともに追っていく必要がある。 現状、それぞれに月1で投稿する目標がありつつも達成からは程遠い。。。
来年やっていきたいこと
GraphQL RubyでIntrospectionクエリをクライアント別に制御する方法
GraphQL Rubyを使用しているプロジェクトで、Introspectionクエリをクライアント毎に有効化、無効化の制御を行いたいことがあったので、その方法を備忘として残しておきたいと思います。
前提
graphql-rubyでは、GraphQL::Schemaの継承クラスでdisable_introspection_entry_pointsを定義することで、Intorospectionのエントリーポイント(__schema,__type)を無効化することがでできます。
公式ドキュメントより
class MySchema < GraphQL::Schema
  disable_introspection_entry_points if Rails.env.production?
end
ただ、例のように本番環境のみIntrospectionクエリを無効化するようなユースケースであれば問題ないですが、リクエスト元のクライアントを判定して、Introspectionクエリの有効、無効を細かく制御したい場合にはそのまま使うことができません。
調べてみたところ、Introspectionを拡張することでContext情報に基づいたエントリーポイントの制御ができるようでした。
また、動作環境は以下を前提とします。
Context情報に基づいたエントリーポイントの制御
GraphQL Rubyの作者のrmosolgoさんのgistでその方法が紹介されているので、参考にしつつ説明していきます。
CustomIntrospectionモジュールを定義しIntrospection名前空間内で、Introspectionクエリで出力される各オブジェクトの定義を上書きます。
__Schema: built-in introspection types__schema: introspection entry points__typename: dynamic, globally-available fields
各オブジェクトのFieldやSchema定義のvisible?メソッドをoverrideし、Context情報が特定の条件に該当する場合にのみFieldやSchemaが出力されるようにします。
app/graphql/custom_introspection.rb
module CustomIntrospection
    module HideIntrospectionByContext
      def visible?(ctx)
        super &&
          if introspection?
            ctx[:introspection_permitted]
          else
            true
          end
      end
    end

    # globally-available fields
    class IntrospectionField < GraphQL::Schema::Field
      include HideIntrospectionByContext
    end

    # dynamic fields
    class DynamicFields < GraphQL::Introspection::DynamicFields
      field_class(IntrospectionField)
      field :__typename, String, null: false
    end

    # introspection entry points
    class EntryPoints < GraphQL::Introspection::EntryPoints
      field_class(IntrospectionField)
      field :__type, GraphQL::Introspection::TypeType do
        argument :name, String
      end
    end

    # built-in introspection types
    class SchemaType < GraphQL::Introspection::SchemaType
      extend HideIntrospectionByContext
    end
  end
上記で定義した、作成したカスタムCustomIntrospectionモジュールをGraphQL::Schemaの継承クラスに定義します。
app/graphql/my_schema.rb
class MySchema < GraphQL::Schema

    introspection(CustomIntrospection)

    ...
end
出力の例
通常のクエリは問題なく実行できます(visible?メソッド内のintrospection?でIntrospectionクエリのみを制御の対象にできている)
pp MySchema.execute(things_query_str, context: {}).to_h

# {"data"=>
#   {"things"=>
#     [{"name"=>"Pogo Stick"},
#      {"name"=>"Immersion Blender"},
#      {"name"=>"Ceiling Fan"}]}}
introspection_permittedがtrueの場合はIntrospectionクエリの実行が可能です
pp MySchema.execute(GraphQL::Introspection::INTROSPECTION_QUERY, context: { introspection_permitted: true }).to_h

# {"code"=>"useAndDefineFragment", "fragmentName"=>"FullType"}}]}
# {"data"=>
#   {"__schema"=>
#     {"queryType"=>{"name"=>"Query"},
#      "mutationType"=>nil,
#      "subscriptionType"=>nil,
#      "types"=> # ...
introspection_permittedがContext情報にない場合は、Introspectionクエリに失敗します
pp MySchema.execute(GraphQL::Introspection::INTROSPECTION_QUERY, context: {}).to_h

# {"errors"=>
#   [{"message"=>"Field '__schema' doesn't exist on type 'Query'",
# ...
まとめ
GraphQL::Schemaの継承クラスでdisable_introspection_entry_pointsを定義することで、環境変数や定数をベースに全体のIntrospectionクエリの実行可否を制御することは可能- クエリを実行してくるクライアント毎にIntrospectionクエリの実行可否を制御するには、Introspection名前空間内で、visible?メソッドのオーバーライドしContextに基づいたスキーマ情報の可視、不可視の切り替えを行うことで実現することができる
参考
open-uriライブラリ10kbの罠
RakeタスクでとあるCSVファイルをダウンロードしながら(CSV.foreach)、データの加工やDBへの保存処理を行うスクリプトを作成していたところ、以下にあるような課題に当たって、ヘルパーメソッドを作成したので背景とともに残しておく
背景と課題
- ローカルで手軽にRakeタスクを実行したいが、HerokuでホストされているDBへのIOに時間がかかる
- GCSのバケットにあらかじめアップロードしておいたCSVファイルを
URI.parse('<https://storage.google.xxx.com/sample.csv>').openを使用し、http経由でダウンロードするようにしたところ、10kb以下のファイルがStringIOで返ってくるためうまくいかない
openメソッドはOpenURI::Buffer のStringMax 定数(10kb)を見てバッファ(StringIO)で処理するかどうかを判断しているおり、ファイル中のデータサイズが10kb以下の場合でそれぞれ、返されるオブジェクトの種類が異なる。
一方、CSV.foreach はIO stream可能なオブジェクトを引数にする必要があるため、一工夫必要
つくったもの
CSV.foreachで扱えるIO stream可能なオブジェクトを返すヘルパーメソッドを作成してみた- ついでにパス・URL指定どちらも指定できるように
require 'open-uri'

def read_as_path_or_io(path_or_url)
  safe_uri = URI.parse(path_or_url)

  # localのファイルシステムから参照
  if safe_uri.scheme.nil?
    return path_or_url
  end

  stream = safe_uri.open

  # 10kb以上のファイルをhttp or ftpから参照
  return stream if stream.respond_to?(:path)

  # 10kb以下のファイルをhttp or ftpから参照
  Tempfile.new.tap do |file|
    file.binmode
    IO.copy_stream(stream, file)
    stream.close
    file.rewind
  end
end

# 呼び出し
temp_file = read_as_path_or_io('ローカルのファイルパス or URL')
CSV.foreach(temp_file, encoding: 'UTF-8', headers: true).do |csv|
  p csv
end
参考
https://github.com/ruby/csv/blob/master/lib/csv.rb https://github.com/gitlabhq/gitlabhq/blob/master/spec/support/helpers/rake_helpers.rb https://stackoverflow.com/questions/31527154/rails-open-returns-stringio-instead-of-tempfile https://docs.ruby-lang.org/ja/latest/library/open=2duri.html https://stackoverflow.com/questions/31527154/rails-open-returns-stringio-instead-of-tempfile https://docs.ruby-lang.org/ja/latest/class/Tempfile.html
Railsの初期化コードと置き場所
Railsでconfig配下に置く各種初期化ファイルについて、それぞれのユースケースや実行の順番について整理しておきます。
今回はRailsガイドでも挙げられている、代表的な初期化コードの配置および定義場所を扱います。
- config/application.rb
- config/environments 配下
- config/initializers 配下
- initialization events
config/application.rb
Railsアプリケーションの起動時にgemなどに依存しない、1番はじめに実行させたい共通の初期化コードを書きます。
Rails::ApplicationはRails::Railtieを間接的に継承しているため、config/application.rbでinitializerメソッドを使用して、アプリケーションの初期化処理を定義することができます。
config/environments 配下
環境毎の初期化コードが書かれた設定ファイルを置きます。 例えば、config/environments/production.rbなどが該当します。
config.active_storage.serviceを、環境毎に:localや:amazonなどに変更するような使い方をイメージするとよいです。
config/initializers 配下
環境にかかわらず共通で行う初期化コードが書かれた設定ファイルを置きます。 gemやRailsのフレームワークで使用する初期化コードが置かれることが多いです。
initialization events
Rails::Application, Rails::Railtie, Rails::Engineのサブクラスで使用可能な初期化時のイベントフックが5つ存在します。
- before_configuration
- before_initialize
- to_prepare
- before_eager_load
- after_initialize
after_initialize 使用されることが多いイベントフックで
- Railsアプリケーション(フレームワーク)の初期化が完了した後の初期化コード
- gemに依存する初期化コード
などを書きます。
実行の順番
実行の順番についてまとめておくとそれぞれ、以下となります。
初期化の順番
- config/application.rb
- config/environments 配下
- config/initializers 配下
また、config/initializers配下のファイルの読み込みの順番はアルファベットや数字の並び順にファイルが読み込まれるため、01,02のようなプレフィックスをファイル名につけることで、実行の順番を保証することができます。
初期化イベントの呼び出される順番
- initialization events
- config/application.rbに定義
- config/environments 配下に定義
- config/initializers 配下に定義
実際に動かしてみる
実際に各初期化ファイルやコードがどの順番で実行されているかも確認しておきます。 開発者モード(RAILS_ENV=development)で検証しています。
config/application.rb
class Application < Rails::Application
    ...
    puts "config/application.rb"
    ...
end
config/environments/development.rb
Rails.application.configure do
    ...
  puts "config/environments/development.rb"
  ...
end
config/initializers/application_controller_renderer.rb
...
puts "config/initializers/application_controller_renderer.rb"
...
config/initializers/mime_types.rb
...
puts "config/initializers/mime_types.rb"
...
結果
config/application.rb
config/environments/development.rb
config/initializers/application_controller_renderer.rb
config/initializers/mime_types.rb
上記に加えて、各ファイルでafter_initializeを定義してみます。
config/application.rb
class Application < Rails::Application
    ...
    puts "config/application.rb"

    Rails.application.config.after_initialize do
        puts "config/application.rb | after_initialize"
    end
    ...
end
config/environments/development.rb
Rails.application.configure do
    ...
  puts "config/environments/development.rb"

    Rails.application.config.after_initialize do
        puts "config/environments/development.rb | after_initialize"
    end
  ...
end
config/initializers/application_controller_renderer.rb
...
puts "config/initializers/application_controller_renderer.rb"

Rails.application.config.after_initialize do
  puts 'config/initializers/application_controller_renderer.rb | after_initialize'
end
...
結果
config/application.rb
config/environments/development.rb
config/initializers/application_controller_renderer.rb
config/initializers/mime_types.rb
↓after_initialize↓
config/application.rb | after_initialize
config/environments/development.rb | after_initialize
config/initializers/cors.rb | after_initialize
Config gemを使う場合の注意
ここからは番外編です。 定数値を管理するためにConfig gemがよく使用されるかと思いますが、gem側で初期化のタイミングを必ず一番はじめに強制する挙動があるため注意が必要です。
特に、Config gemの初期化の前に、Rails.applicationの初期化に依存する事前処理を行いたい場合に考慮が必要となります。
initialization eventsのbefore_configurationを使用したとしても、対象の処理をConfig gemの初期化処理よりも前に持ってくることができません。
これは、Config gemがRails::Railtieを継承したクラス内で、before_configurationを定義することで初期化のタイミングをトップレベルに持ってきていることによる挙動となります。
そのため、config/initializers/config.rbの初期化ブロックの一番最初の処理として、Rails.applicationの初期化に依存する処理を書くことになります。
Config.setup do |config|
    Rails.application...
    ...
end
参考
https://guides.rubyonrails.org/initialization.html https://guides.rubyonrails.org/configuring.html https://github.com/rubyconfig/config/blob/master/lib/config/integrations/rails/railtie.rb
